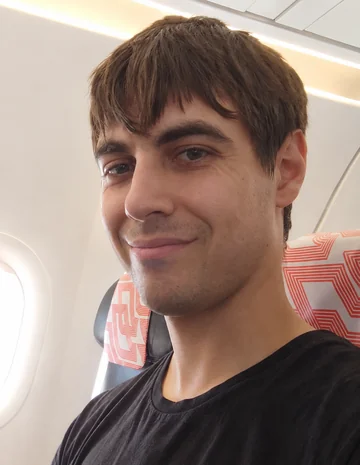
Antoine Limasset
English · Français · CV (PDF, anglais)
Chargé de recherche CNRS · CRIStAL · Université de Lille
Équipe Bonsai — Algorithmes et structures de données pour l’analyse de séquences
Publications · Logiciels · Équipe · Financements · Enseignement · Contact
Présentation
Je suis chargé de recherche CNRS dans l’équipe Bonsai du laboratoire CRIStAL, à l’Université de Lille. Je conçois des algorithmes et des structures de données pour analyser de grandes collections de séquences génomiques et transcriptomiques, à l’interface entre informatique théorique et bioinformatique.
Mes travaux portent sur l’indexation de séquences, les représentations compactes de k-mers, la compression, les méthodes d’esquisse et la correction des erreurs de séquençage. Je développe des logiciels libres pour réduire les besoins en mémoire et en calcul de l’analyse de séquences à grande échelle.
J’ai obtenu mon habilitation à diriger des recherches (HDR) à l’Université de Lille en septembre 2025.
Publications
Rechercher dans la bibliographie · citations et BibTeX · Google Scholar
Télécharger toutes les références (BibTeX)
2026
-
ZOR Filters: Fast and Smaller Than Fuse Filters
24th International Symposium on Experimental Algorithms (SEA 2026), LIPIcs 371, 24:1–24:17. Schloss Dagstuhl – Leibniz-Zentrum für Informatik. -
Compressed inverted indexes for scalable sequence similarity
RECOMB 2026. Texte disponible : prépublication bioRxiv, déposée en 2025. -
Minimizer Density revisited: Models and Multiminimizers
RECOMB 2026. Texte disponible : prépublication bioRxiv, déposée en 2025. -
Super Bloom: Fast and precise filter for streaming k-mer queries
RECOMB-Seq 2026 ; prépublication bioRxiv. -
Accelerating k-mer-based sequence filtering
Peer Community Journal, 6, e55.
2025
-
Inverted colored de Bruijn Graph for practical kmer sets storage
bioRxiv, prépublication. -
Fractional hitting sets for efficient multiset sketching
Algorithms for Molecular Biology, 20 (1), 1. -
REINDEER2: Practical Abundance Index at Scale
String Processing and Information Retrieval (SPIRE 2025), Lecture Notes in Computer Science 16073, 156–171. Springer Nature. -
OReO: optimizing read order for practical compression
Bioinformatics Advances, 5 (1), vbaf128. -
K2R: Tinted de Bruijn graphs implementation for efficient read extraction from sequencing datasets
Bioinformatics Advances, 5 (1), vbaf111. -
Hyper-k-mers: Efficient Streaming k-mers Representation
Research in Computational Molecular Biology (RECOMB 2025), Lecture Notes in Computer Science 15647, 330–335. Springer Nature.
2024
-
Automated evaluation of multiple sequence alignment methods to handle third generation sequencing errors
PeerJ, 12, e17731. -
Conway–Bromage–Lyndon (CBL): an exact, dynamic representation of k-mer sets
Bioinformatics, 40 (Suppl. 1), i48–i57. -
Brisk: Exact resource-efficient dictionary for k-mers
bioRxiv, prépublication. -
Evaluating k-mer Transformations for Cache Coherence and Uniformity
Zenodo, prépublication.
2023
-
Locality-preserving minimal perfect hashing of k-mers
Bioinformatics, 39 (Suppl. 1), i534–i543. -
Scalable sequence database search using partitioned aggregated Bloom comb trees
Bioinformatics, 39 (Suppl. 1), i252–i259. -
Fractional Hitting Sets for Efficient and Lightweight Genomic Data Sketching
23rd International Workshop on Algorithms in Bioinformatics (WABI 2023), LIPIcs 273, 15:1–15:27. Schloss Dagstuhl – Leibniz-Zentrum für Informatik.
2022
- Toward Optimal Fingerprint Indexing for Large Scale Genomics
22nd International Workshop on Algorithms in Bioinformatics (WABI 2022), LIPIcs 242, 25:1–25:15. Schloss Dagstuhl – Leibniz-Zentrum für Informatik.
2021
-
BLight: efficient exact associative structure for k-mers
Bioinformatics, 37 (18), 2858–2865. -
Scalable long read self-correction and assembly polishing with multiple sequence alignment
Scientific Reports, 11 (1), 761.
2020
-
Toward perfect reads: self-correction of short reads via mapping on de Bruijn graphs
Bioinformatics, 36 (5), 1374–1381. -
ELECTOR: evaluator for long reads correction methods
NAR Genomics and Bioinformatics, 2 (1), lqz015. -
A resource-frugal probabilistic dictionary and applications in bioinformatics
Discrete Applied Mathematics, 274, 92–102.
2019
- Read correction for non-uniform coverages
bioRxiv, prépublication.
2017
- Fast and Scalable Minimal Perfect Hashing for Massive Key Sets
16th International Symposium on Experimental Algorithms (SEA 2017), LIPIcs 75, 25:1–25:16. Schloss Dagstuhl – Leibniz-Zentrum für Informatik.
2016
-
Compacting de Bruijn graphs from sequencing data quickly and in low memory
Bioinformatics, 32 (12), i201–i208. -
Read mapping on de Bruijn graphs
BMC Bioinformatics, 17 (1), 237. -
A Resource-frugal Probabilistic Dictionary and Applications in (Meta)Genomics
Proceedings of the Prague Stringology Conference 2016, 85–98. Jan Holub and Jan Žďárek (eds.), Czech Technical University in Prague.
2015
- On the Representation of De Bruijn Graphs
Journal of Computational Biology, 22 (5), 336–352.
2014
- On the Representation of de Bruijn Graphs
Research in Computational Molecular Biology (RECOMB 2014), Lecture Notes in Computer Science 8394, 35–55. Springer.
Publications en collaboration
2022
- Critical Assessment of Metagenome Interpretation: the second round of challenges
Nature Methods, 19 (4), 429–440.
2021
-
Chromosome-level genome assembly reveals homologous chromosomes and recombination in asexual rotifer Adineta vaga
Science Advances, 7 (41), eabg4216. -
STRONG: metagenomics strain resolution on assembly graphs
Genome Biology, 22 (1), 214.
Logiciels
Indexation, recherche et structures de données
-
ZOR
Filtres d’appartenance approchée économes en mémoire.
-
SuperBloom
Filtres de Bloom rapides pour les requêtes de k-mers en flux.
-
Onika
Index inversés compressés pour rechercher des séquences similaires à grande échelle.
-
REINDEER2
Indexation et interrogation des abondances de k-mers à grande échelle.
-
K2R
Extraction exacte des lectures contenant des k-mers donnés.
-
K2Rmini
Filtrage rapide de séquences fondé sur les k-mers.
-
KFC
Comptage de k-mers à l’aide de représentations compactes en hyper-k-mers.
-
CBL
Ensembles exacts et dynamiques de k-mers, avec opérations ensemblistes.
-
LPHASH
Hachage parfait minimal compact de k-mers préservant la localité.
-
PAC
Recherche dans des bases de séquences à l’aide de Partitioned Aggregated Bloom Comb-Trees.
-
BLight
Dictionnaires associatifs exacts et efficaces pour les k-mers.
-
Brisk
Dictionnaire exact de k-mers économe en ressources.
-
BBHash
Hachage parfait minimal rapide pour des ensembles massifs de clés.
-
BCALM2
Construction de graphes de de Bruijn compactés en faible mémoire.
-
SRC
Estimation des abondances de séquences et recherche de similarités entre lectures.
Compression
Esquisses et similarité
-
SuperSampler
Esquisses génomiques efficaces à l’aide d’ensembles transversaux fractionnaires.
-
NIQKI
Indexation d’empreintes pour comparer des esquisses génomiques à grande échelle.
Correction d’erreurs, alignement et assemblage
-
MSA-Limit
Évaluation des méthodes d’alignement multiple face aux erreurs de séquençage.
-
STRONG
Résolution de souches métagénomiques sur les graphes d’assemblage.
-
CONSENT
Autocorrection des lectures longues et polissage d’assemblages par alignement multiple.
-
BCOOL
Correction des lectures courtes à l’aide de graphes de de Bruijn.
-
BGREAT
Alignement des lectures sur les graphes de de Bruijn.
-
BWISE
Assemblage de lectures courtes pour les génomes hétérozygotes et polyploïdes.
-
ELECTOR
Évaluation des méthodes de correction de lectures longues.
-
BRRR
Correction de lectures longues à partir du spectre des k-mers.
Équipe et encadrement
Doctorants actuels
-
Étienne Conchon-Kerjan — Directeur de thèse, depuis 2026.
-
Yohan Hernandez-Courbevoie — Directeur de thèse, depuis 2024. Indexation de bases de données transcriptomiques globales.
-
Timothé Rouzé — Co-encadrant de thèse, depuis 2023. Compression de grandes collections de données de séquençage.
Ingénieurs et postdoctorants
-
Lucas Robidou — Ingénieur de recherche, encadrant, depuis 2026. Analyse de séquences génomiques à grande échelle.
-
Florian Ingels — Postdoctorant, encadrant, 2025–2026. Schémas de minimiseurs.
Anciens doctorants et collaborateurs
-
Léa Vandamme — Directeur de thèse, 2022–2025. Indexation de données de séquençage de troisième génération.
-
Caleb Smith — Ingénieur, encadrant, 2023–2024. Compression de grandes collections de données de séquençage.
-
Coralie Rohmer — Co-encadrant de thèse, 2019–2023. Algorithmes d’alignement multiple adaptés au séquençage de troisième génération.
Formation
- 2025 — Habilitation à diriger des recherches (HDR), Université de Lille. Soutenue le 4 septembre 2025.
- 2017 — Doctorat en informatique, Université de Rennes 1. Novel approaches for the exploitation of high throughput sequencing data. Sous la direction de Pierre Peterlongo et Dominique Lavenier ; soutenu le 12 juillet 2017.
- 2014 — Master en informatique, École normale supérieure de Rennes.
- 2012 — Licence en informatique, École normale supérieure de Cachan.
Expérience professionnelle
- Depuis 2018 — Chargé de recherche CNRS, équipe Bonsai, CRIStAL, Lille, France.
- 2017 — Chercheur postdoctoral, Université libre de Bruxelles, Belgique. Assemblage de novo de génomes hétérozygotes.
Financements
-
2026 — ANR PRC GRANDSMERS, responsable scientifique, environ 585 k€. Graph-based Research on Accurate Nucleotide Data via Scalable, Multi-scale, and Efficient RepresentationS.
-
2026 — ANR PRC PRO-K-MER, membre. PRObabilistic K-MERs for environmental sequence analysis.
-
2024 — MIC INSERM, responsable scientifique, 554 k€. Analyse efficace et évolutive du cancer par exploration transcriptomique avancée à grande échelle.
-
2024 — ANR Shannon x Cray, membre, 500 k€.
-
2021 — ANR JCJC, responsable scientifique, 227 k€. Adequate graph structures for third-generation sequencing data exploration.
-
2019 — Financement doctoral de la Région Hauts-de-France, responsable scientifique, 150 k€.
-
CDP PIE — Protein-Interaction-Evolution — Initiative d’Excellence de l’Université de Lille. Financement total du projet : 1,5 M€ sur 4 ans, renouvelable.
Enseignement
- 2026 — Intervenant, EMBO Practical Course on Pangenomics, Naples, Italie.
- 2026 — Équipe pédagogique et organisation, Scalable Genomics and Pangenomics, Wellcome Genome Campus, Hinxton, Royaume-Uni.
- 2020–2027 — Cours d’assemblage de génomes en master, France.
- 2019–2026 — Cours d’assemblage de génomes, atelier Evomics, République tchèque.
- 2023–2026 — Cours d’assemblage de génomes, CNRS Formation, France.
- 2015–2017 — Programmation fonctionnelle en licence, France.
Responsabilités scientifiques
Comités de conférences
- Comités de programme : RECOMB (2020–2026), ECCB/ISMB (2020–2026), SeqBim (2020–2025), ACM-BCB (2020–2024).
- Comité d’organisation : SPIRE (2021).
Évaluation d’articles
Nature Communications, Nature Methods, Genome Research, Genome Biology, Nucleic Acids Research, Bioinformatics, Scientific Reports et autres revues et conférences.
Jurys et comités de thèse
- Nastasija Mijovic — Comité de thèse, 2023–2025.
- Riku Walve — Examinateur, 2022.
- Svitlana Lukicheva — Jury de thèse, 2021.
- Théo Lemane — Comité de thèse, 2020–2021.
- Nadege Guiglielmoni — Comité de thèse, 2019–2020.
Conférences et présentations
-
2026 — Conférence invitée, JC2B — Junior Conference on Computational Biology, Gif-sur-Yvette, France.
-
2026 — RECOMB et RECOMB-Seq, Thessalonique, Grèce.
-
2024 — EMBL-EBI K-mer/sequence indexing workshop, Cambridge, Royaume-Uni.
-
2024 — Kmer days, Dijon, France.
-
2023 — ISMB, Lyon, France.
-
2022 — RECOMB, San Diego, États-Unis.
-
2022 — DSB, Düsseldorf, Allemagne.
-
2022 — TUDASTIC, Lille, France.
-
2022 — Réunion de lancement de Genopim, Rennes, France.
-
2021 — Kmer days, Marville, France.
-
2019 — Biata, Saint-Pétersbourg, Russie.
-
2018 — RECOMB, Paris, France.
Contact
Antoine Limasset
CRIStAL (UMR 9189), Université de Lille
Bâtiment ESPRIT, 59655 Villeneuve-d’Ascq, France